Miten rakennetaan tekoälyratkaisu, joka toimii luotettavasti kymmenillä eri kielillä myös todellisissa käyttötilanteissa? Vy:n tapauksessa ratkaisevaa ei ollut itse kielimalli, vaan tiedonhaun osuvuuden parantaminen. AI Engineer Sigurd Johnsen Setså kertoo, mikä muuttui matkalla PoC:sta tuotantoon. Pekka Mikkola ja Markku Alanko puolestaan avaavat, mikä yhdistää onnistuneita tekoälyratkaisuja eri organisaatioissa.
Prototyypistä tuotantovalmiiksi ratkaisuksi
Vy:n tapauksessa lähtökohta oli hyvin käytännöllinen. Bussinkuljettajien piti löytää nopeasti työssään tarvitsemansa ohjeet, mutta tieto oli hajallaan pitkissä dokumenteissa ja useissa järjestelmissä. Kiireisessä työarjessa tämä tarkoitti turhaa ajankäyttöä ja epävarmuutta tilanteissa, joissa tiedon täytyy olla yksiselitteistä. (Lue koko Vy:n tarina tästä.)
AI Engineer Sigurd Johnsen Setså osallistui ratkaisun suunnitteluun ja toteutukseen käytännössä alusta asti.
"Teknisestä näkökulmasta toimivan ratkaisun rakentaminen ei ollut vaikeinta. Todellinen haaste alkoi vasta siinä vaiheessa, kun halusimme tehdä siitä aidosti hyödyllisen arjen tilanteissa. Toimivan proof of conceptin ja aidosti arvoa tuottavan ratkaisun välillä on suuri ero."
Ensimmäinen versio noudatti tuttua rakennetta: käyttäjän kysymys, tiedonhaku dokumentaatiosta ja sen pohjalta muodostettu vastaus. Rajatussa testauksessa ratkaisu toimi varsin hyvin. Erot tulivat esiin vasta silloin, kun sitä testattiin oikeilla käyttäjillä.
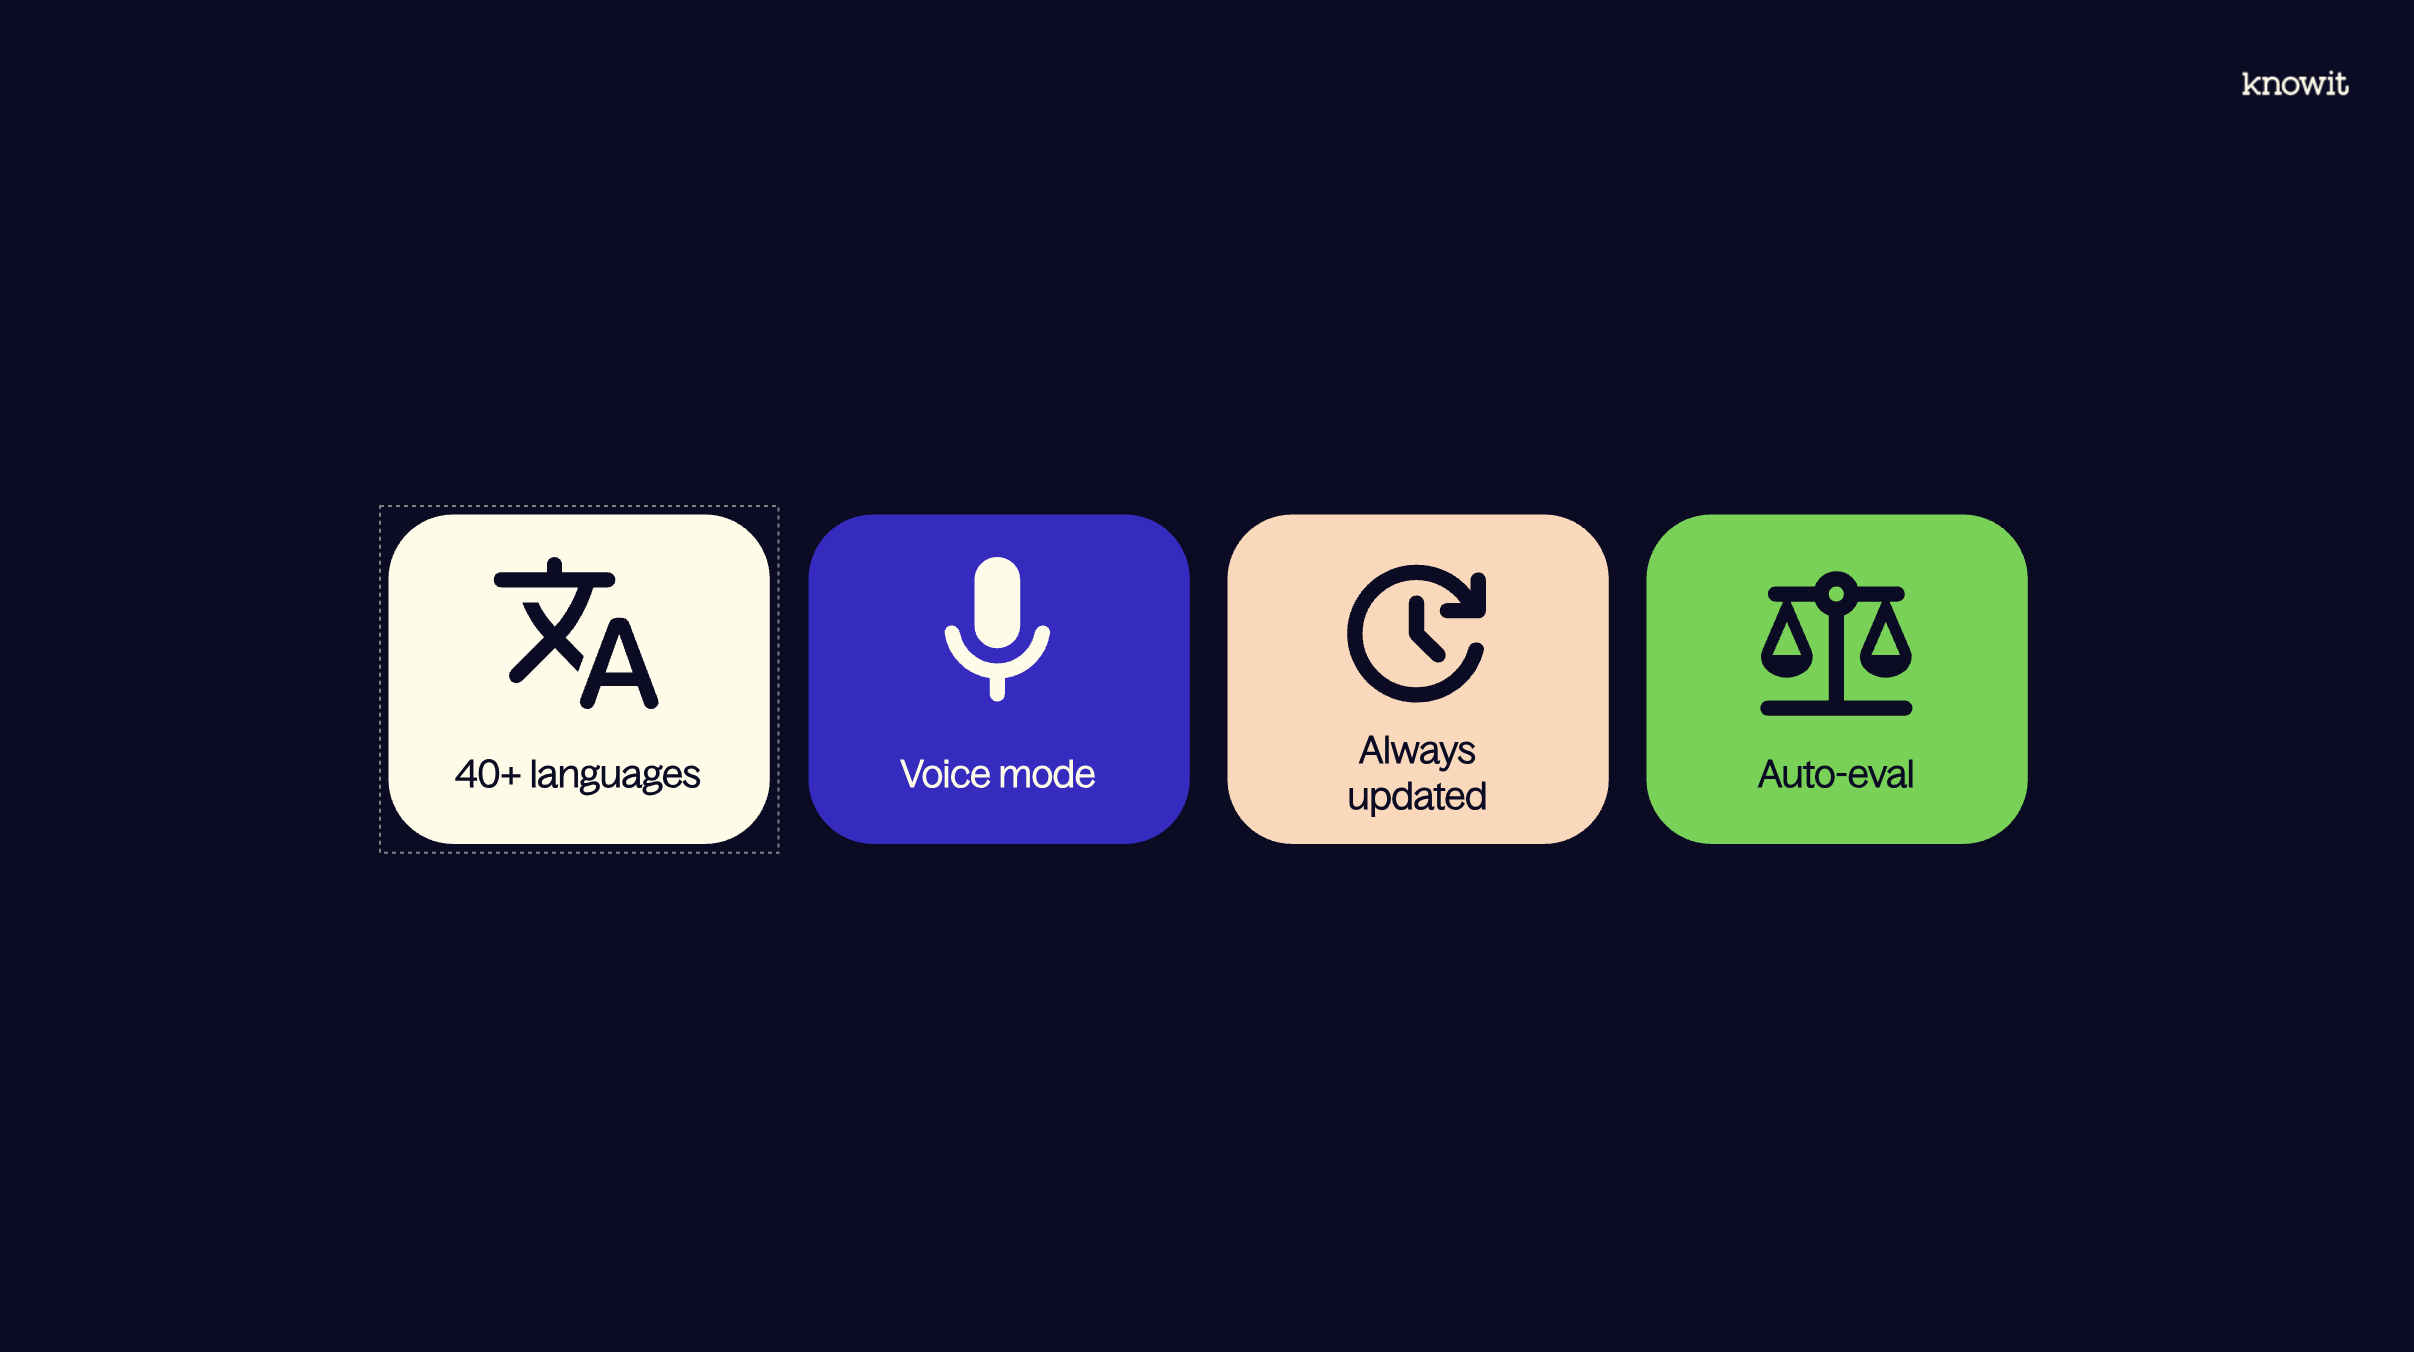 Ratkaisu tukee yli 40 kieltä, tarjoaa puheohjauksen, hyödyntää aina ajantasaista tietoa ja sisältää automaattisen laadun arvioinnin.
“Joillakin kielillä ratkaisu toimi hyvin. Toisilla ei. Yhdessä testissä rengasrikkoa koskeva kysymys johti vastaukseen joulusta. Siinä vaiheessa tajusimme, ettei ratkaisu ollut vielä valmis."
Kun järjestelmä hakee väärän tiedon, siihen on vaikea enää luottaa. Juuri tässä vaiheessa moni tekoälyhanke pysähtyy. Toimiva PoC ei vielä tarkoita ratkaisua, joka toimii luotettavasti myös käytännössä.
"Dataan perustuvien käyttötapausten näkökulmasta tämä oli erityisen kiinnostavaa. LLM-mallit ovat mahdollistaneet aivan uudenlaisia tapoja hakea tietoa eri kielillä kirjoitetuista dokumenteista, yhtenäistää niiden sisältöä ja tuottaa vastauksia eri kanaviin ja eri kielillä. Sama toimintamalli on hyödynnettävissä monissa organisaatioissa, jotka toimivat useissa maissa ja kulttuureissa, mutta ratkaisevat samanlaisia arjen tilanteita", sanoo Markku Alanko, Head of Data Platforms Offering ja Principal Consultant.
Tiedonhaun osuvuus ratkaisi
Kun ensimmäiset ongelmat tulivat näkyviin, huomio siirtyi siihen, miten järjestelmä löytää oikean tiedon mahdollisimman luotettavasti.
Setsån mukaan ongelma ei ollut itse kielimallissa, vaan tiedonhaun epäjohdonmukaisuudessa.
"Yksi ensimmäisistä asioista, joita tarkastelimme, oli embedding-malli. Se oli suhteellisen helppo parannus. Pystyimme vaihtamaan paremman monikielisen mallin ja testaamaan vaikutukset nopeasti. Se auttoi, mutta ei ratkaissut ongelmaa yksin."
Välillä järjestelmä löysi oikeat dokumentit, välillä ei. Kun konteksti oli väärä, myös vastaus oli väärä.
"Siinä vaiheessa ymmärsimme, että meidän piti parantaa tiedonhakua, ei pelkästään vastausten generointia."
Työtä jatkettiin vaiheittain.
"Lisäsimme re-ranking-vaiheen, jotta hakutulokset vastaisivat paremmin käyttäjän tarkoitusta. Yhdistimme myös semanttisen ja sanahakuun perustuvan tiedonhaun, jotta ratkaisu toimisi paremmin tilanteissa, joissa käännökset tai sanamuodot vaihtelevat. Lisäksi testasimme sekä kysymysten kääntämistä että niiden käsittelyä alkuperäisellä kielellä kontekstin säilyttämiseksi."
Näiden muutosten myötä tiedonhaun osuvuus parani merkittävästi.
"Siinä vaiheessa aloimme huomata, että ratkaisu kestää myös oikean käytön", Setså sanoo.
Head of Data & AI Offering ja Principal Consultant Pekka Mikkola näkee saman ilmiön toistuvan monissa organisaatioissa.
“Monessa organisaatiossa lähdetään edelleen liikkeelle alhaalta ylöspäin: käytettävissä oleva data syötetään mallille, joka tuottaa vastauksia. Vastaukset eivät kuitenkaan aina vastaa käyttäjien odotuksia, vaan voivat olla virheellisiä tai harhaanjohtavia. Käytännössä ratkaisevaa on se, kuinka luotettavasti oikea tieto saadaan oikeassa kontekstissa mallin käyttöön. Jos tämä ei toimi, kaikki sen päälle rakennettu kärsii. Kun oikea tieto löytyy oikeassa kontekstissa, myös käyttäjien odotukset voidaan täyttää.
Juuri tässä vaiheessa ratkaisun todellinen arvo alkaa näkyä. Kun tiedonhaku toimii luotettavasti, samaa lähestymistapaa voidaan hyödyntää myös muissa käyttötapauksissa, joissa tiedon on oltava helposti löydettävissä ja hyödynnettävissä."
Käyttäjät mukaan mahdollisimman varhain
Setsån mukaan yksi tärkeimmistä päätöksistä oli luopua ajatuksesta, että ratkaisu pitäisi hioa valmiiksi ennen kuin se annetaan käyttäjille.
"Annoimme ensimmäiset versiot oikeiden käyttäjien käyttöön hyvin varhaisessa vaiheessa. Se muutti koko kehitystyön dynamiikan. Näimme heti asioita, joita emme olisi koskaan havainneet hallitussa testiympäristössä – miten ihmiset muotoilevat kysymyksiä, missä data ei riitä ja miten eri kielet vaikuttavat lopputulokseen."
Painopiste siirtyi valmiin ratkaisun rakentamisesta sen jatkuvaan kehittämiseen todellisen käytön pohjalta.
"Pienten AI-demojen rakentaminen ei ole koskaan ollut näin helppoa. Niiden vieminen tuotantoon on kuitenkin huomattavasti haastavampaa, ja juuri siinä moni hanke pysähtyy. Idea voi olla hyvä, mutta ilman kunnollista arviointikehikkoa et tiedä, ratkaiseeko sovellus käyttäjien todellisia ongelmia ennen kuin on liian myöhäistä. Siksi panostimme alusta alkaen vahvasti automatisoituun testikokonaisuuteen, joka perustui oikeiden käyttäjien palautteeseen."
Käytännössä tämä tarkoitti ratkaisun käytön, vastausten ja epäonnistumisten jatkuvaa seurantaa. Näin kehitystyötä voitiin ohjata todellisen käytön eikä oletusten perusteella.
Toinen tärkeä tekijä oli se, miten ratkaisu rakennettiin alusta alkaen.
"Jos teknistä ratkaisua ei tehdä oikein alusta asti, joudut rakentamaan kaiken uudelleen sen sijaan, että voisit kehittää olemassa olevaa. Kun tavoitteena on tuotantovalmis ratkaisu, sen päälle täytyy pystyä rakentamaan. Se vaikuttaa kaikkeen datan käsittelystä mallien arviointiin ja päivittämiseen."
LLM-teknologiat kehittyvät nopeasti. Osa työkaluista ja arviointimenetelmistä, joita aiemmat teknologiaversiot vielä edellyttivät, voi tulevaisuudessa sisältyä alustoihin valmiina. Tämä korostaa entisestään vaiheittaisen ja iteratiivisen kehittämisen merkitystä.
Arkkitehtuuri tukee jatkuvaa kehittämistä
Ratkaisun arkkitehtuuri pidettiin tarkoituksella yksinkertaisena. Käyttäjän syöte kulki kieli- ja puhepalveluiden kautta Databricksissa toimivalle AI-komponentille, jossa myös tiedonhaku, embeddingit ja datan käsittely hoidettiin samassa ympäristössä.
Setsån mukaan tällä oli myös käytännön etuja.
"Halusimme pitää mahdollisimman paljon samassa paikassa. Se vähentää käyttöoikeuksiin, datan hallintaan ja integraatioihin liittyvää monimutkaisuutta. Samalla eri vaihtoehtoja oli helppo testata ja ratkaisuja kehittää ilman, että koko järjestelmää täytyi rakentaa uudelleen."
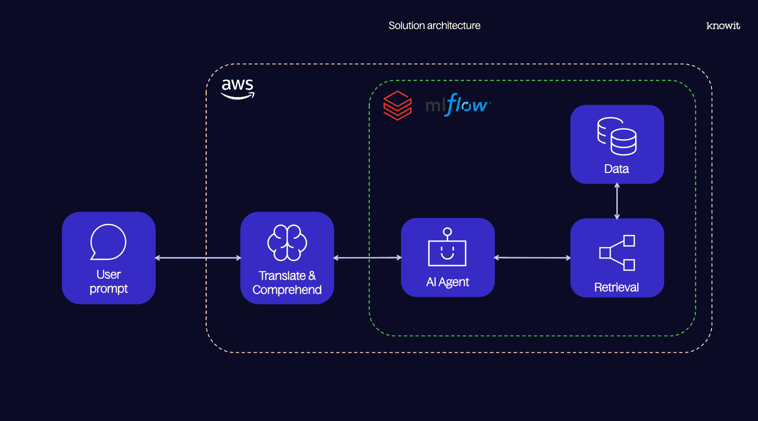 Ratkaisun arkkitehtuuri yhdistää monikielisen käsittelyn, AI-agentin, tiedonhaun ja datan samaan ympäristöön. Yhtenäinen kokonaisuus helpottaa kehittämistä, testausta ja jatkuvaa parantamista.
[Arkkitehtuurikuva: Helsingin esityksen slide 9. Kuvateksti: Ratkaisun arkkitehtuuri yhdistää monikielisen käsittelyn, AI-agentin, tiedonhaun ja datan samaan ympäristöön. Yhtenäinen kokonaisuus helpottaa kehittämistä, testausta ja jatkuvaa parantamista. Alt-teksti: Kaavio Vy:n AI-ratkaisun arkkitehtuurista. Käyttäjän kysymys kulkee kielenkäsittelyn kautta AI-agentille, joka hakee tietoa datasta retrieval-komponentin avulla ja muodostaa vastauksen. Ratkaisu hyödyntää AWS:ää ja Databricksin MLflow'ta.]
Alanko korostaa, että tällä lähestymistavalla on merkitystä myös laajemmin.
“Kun data- ja AI-komponentit ovat tiiviisti yhteydessä toisiinsa, ratkaisua on huomattavasti helpompi kehittää ja laajentaa ilman uudelleenrakentamista. Uusien teknologioiden nopea kehitys ja hajautunut innovaatiokenttä asettavat jatkuvaa painetta data-alustoille. Siksi kannattaa nojata vahvoihin alustoihin, joiden ympärille voidaan rakentaa uusia kyvykkyyksiä."
Kun ratkaisu oli tuotannossa, painopiste siirtyi laadun jatkuvaan varmistamiseen. Setsån mukaan arviointi ja seuranta piti tuoda osaksi samaa kokonaisuutta.
"Tarvitaan ihminen, joka tuntee liiketoiminnan ja pystyy arvioimaan ratkaisun laatua. Databricksissa kaikki voidaan kuitenkin koota samaan paikkaan – käytössä voi olla näkymät automaattiselle arvioinnille, käyttäjäpalautteelle ja järjestelmän mittareille. Lisäksi voidaan määrittää hälytyksiä tilanteisiin, joissa laatu alkaa heiketä."
Samalla testaamisesta tuli jatkuva osa kehitystä.
"Mitä enemmän testausta voidaan automatisoida, sitä parempi. Samalla pitää kuitenkin ymmärtää sen rajat. Esimerkiksi yhden LLM:n käyttäminen toisen arviointiin voi siirtää saman ongelman vain uudelle tasolle. Siksi on mietittävä tarkasti, mitä mitataan ja miten tuloksia arvioidaan. Eri käyttötapaukset vaativat myös erilaisia arviointikriteerejä. Kriittisissä ratkaisuissa turvallisuus voi olla tärkein mittari, kun taas myyntiä tukevassa ratkaisussa paino voi olla enemmän käyttäjäkokemuksessa."
Ratkaisua kehitetään edelleen jatkuvasti käytöstä saatavan palautteen ja päivittyvän datan pohjalta.
Enemmän arvoa tekoälystä hyödyntämällä samaa teknistä perustaa uusissa käyttötapauksissa
Mikkolan mukaan sama kehityskaari toistuu organisaatiosta toiseen: PoC toimii omassa testiympäristössään, mutta todellinen käyttö paljastaa sen rajoitteet. Arvo alkaa syntyä vasta, kun nämä haasteet ratkaistaan.
"Tästä kohtaa alkaa se kaikkein kiinnostavin vaihe. Kyse ei ole enää yksittäisestä ratkaisusta, vaan tavasta, jolla se rakennettiin. Näemme tämän toistuvasti: tiimi saa yhden ratkaisun toimimaan, mutta seuraava käyttötapaus aloitetaan jälleen alusta, koska teknistä perustaa ei voida hyödyntää uudelleen."
Mikkolan mukaan menestyvät organisaatiot rakentavat teknisen perustan oikein alusta lähtien – datan yhdistämisestä ja tiedonhausta aina palautemekanismeihin asti.
"Jos tekninen perusta jää alkuvaiheessa puutteelliseksi – miten data yhdistetään, miten tiedonhaku toimii ja miten palautetta hyödynnetään – joudut rakentamaan kaiken uudelleen sen sijaan, että voisit kehittää olemassa olevaa. Kaikkein tärkeintä on ymmärtää käyttäjän tarpeet ja käyttötilanteen asettamat reunaehdot.
Juuri tässä organisaatiot yleensä joko onnistuvat tai epäonnistuvat. Monilla on eri puolilla liiketoimintaa hyvin samankaltaisia ongelmia, mutta niitä ratkotaan silti erillisinä hankkeina. Onnistuminen edellyttää sekä teknisesti vahvaa tiedonhakuratkaisua että sitä, että käytettävyys ja käyttäjäkokemus pysyvät kaiken kehittämisen tähtenä.
Kun samaa teknistä perustaa voidaan hyödyntää uudelleen, ero on merkittävä. Uusien käyttötapausten rakentaminen nopeutuu, ja aikaa voidaan käyttää varsinaisen ongelman ratkaisemiseen sen sijaan, että samoja komponentteja rakennettaisiin yhä uudelleen."
Datan näkökulmasta sama ilmiö näkyy nopeasti myös käytännössä.
"Kun käyttäjät alkavat käyttää ratkaisua oikeasti, samalla paljastuvat datan heikkoudet", Alanko lisää. "Ratkaisun kehittäminen tarkoittaa samalla myös datan kehittämistä."
Opit lyhyesti: miten AI PoC:sta rakennetaan tuotantovalmis ratkaisu
Vy:n tapauksessa ero toimivan PoC:n ja tuotantovalmiin ratkaisun välillä syntyi siitä, että käyttäjät otettiin mukaan varhaisessa vaiheessa, palautteesta tehtiin osa kehitysprosessia ja ratkaisu rakennettiin niin, että sitä voitiin kehittää jatkuvasti.
Organisaatioille, jotka rakentavat tekoälyratkaisuja tänään, haaste ei ole enää pelkästään toimivan PoC:n rakentaminen. Ratkaisun on toimittava myös käytännössä, ja sen täytyy pystyä kehittymään jatkuvasti muuttuvien tarpeiden mukana.
Keskeiset opit:
- Ota käyttäjät mukaan mahdollisimman varhain.
- Keskity tiedonhaun osuvuuteen, älä pelkästään kielimalliin.
- Rakenna palautemekanismit osaksi ratkaisua.
- Perusta kehitys mitattuun tietoon, ei oletuksiin.
- Suunnittele arkkitehtuuri jatkuvaa kehittämistä varten.
- Pidä data ja tekoäly tiiviisti yhdessä.
- Huolehdi jatkuvasta seurannasta ja laadun arvioinnista.
- Hyödynnä samaa teknistä perustaa uusissa käyttötapauksissa.
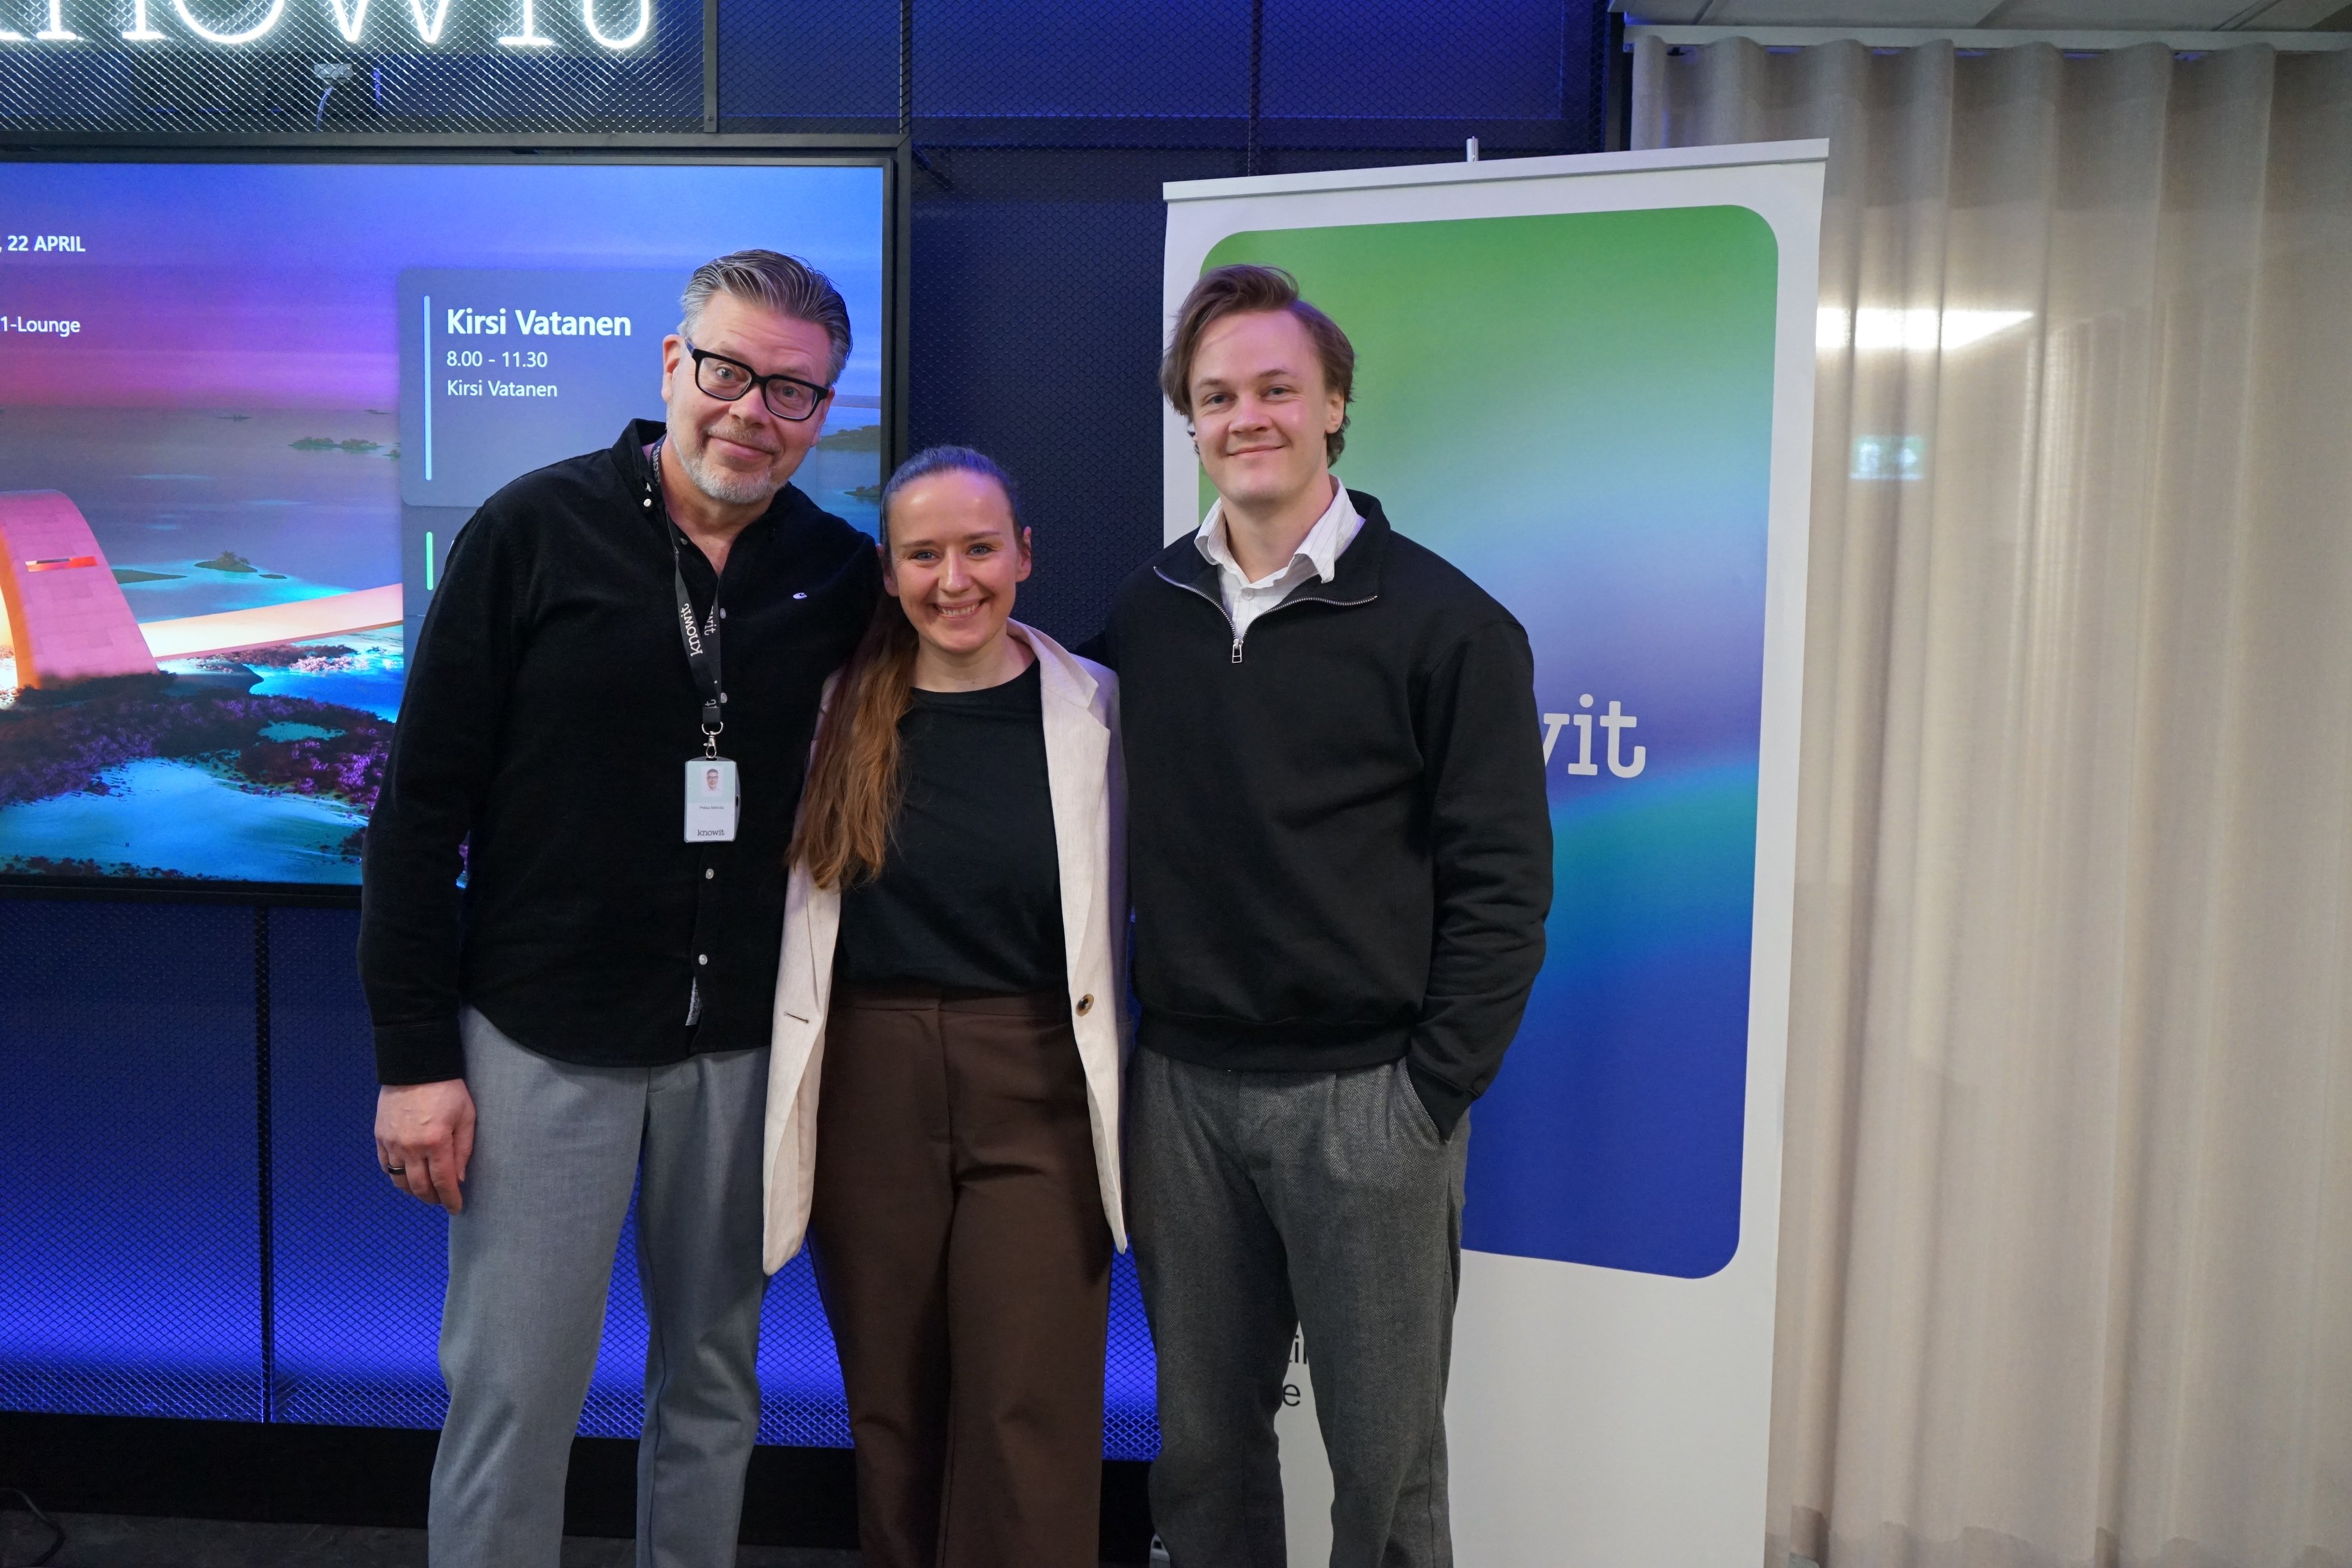 Vasemmalta oikealle: Pekka Mikkola, Julia Førde (Senior Data Engineer ja Databricks MVP) sekä Sigurd Johnsen Setså. Setså esitteli Vy-casen Knowitin Building Value with Modern Data & AI -tapahtumassa.
Haluatko jutella aiheesta lisää?
Keskustellaan siitä, miten samat opit voidaan soveltaa myös teidän AI-hankkeissanne.