Vielä muutama vuosi sitten moderni analytiikkastack tarkoitti käytännössä pitkää ketjua ETL-putkia. Tänään avoimet standardit, kuten Apache Iceberg, sekä modulaariset arkkitehtuurit, kuten data lakehouse, muuttavat perustavanlaatuisesti tapaa, jolla tiimit tallentavat, hallinnoivat ja hyödyntävät dataa.
Olen itse rakentanut näitä vanhoja arkkitehtuureja. Tyypillinen kuvio näytti tältä: tiedostot ladattiin S3-buckettiin, sitten Glue-jobit, Lambda-funktiot ja Step Functions -työnkulut noutivat datan S3-bucketista ja siirsivät sen Snowflakeen. Kuulostaa yksinkertaiselta, mutta käytännössä jossain vaiheessa joku Lambda kaatuu, Glue-jobi ylittää aikarajan tai S3-polku muuttuu, ja koko putki menee rikki.
Lambda-pohjaiset putket ovat monimutkaisia, virhealttiita ja kalliita ylläpitää. Jokainen uusi tuotantopäivitys on mahdollinen ongelma.
Data lakehouse -idea on kuitenkin yksinkertainen: säilytä data laken joustavuus, lisää varastojen suorituskykyä ja rakennetta sekä tee data saataville yhdestä paikasta. Apache Iceberg tekee tästä oikeasti toimivan ratkaisun: ACID-transaktiot, skeeman evoluutio, time travel ja skaalautuva suorituskyky pilvivarastossa ilman toimittajalukitusta.
Tässä vaiheessa työkuormaa voidaan merkittävästi yksinkertaistaa: Trino, Snowflake tai Databricks voi lukea datan suoraan S3-bucketista Iceberg-taulujen kautta. Ei enää tarvetta turhille kopiointivaiheille.
Sama ajatus toimii myös on-prem-ympäristössä: Trino voi muodostaa SQL-kerroksen Apache Iceberg -taulujen yli, vaikka data säilyy edelleen omassa object storage -lähteessä. Tämä tekee mahdolliseksi rakentaa data lakehouse -arkkitehtuuri myös on-prem-infralla.
Mitä Iceberg tuo mukanaan
Iceberg on avoin tauluformaatti. Data elää usein Parquet-tiedostoissa, ja metadata pitää kirjaa siitä, mitkä tiedostot kuuluvat kunkin taulun snapshottiin. Atomiset commitit varmistavat, että lukijat näkevät aina yhdenmukaisen version, vaikka kirjoittajat lisäävät dataa samaan aikaan. Skeeman evoluutio ja tallennetut snapshotit helpottavat muutosten hallintaa.
Datan kirjoittaminen Icebergiin
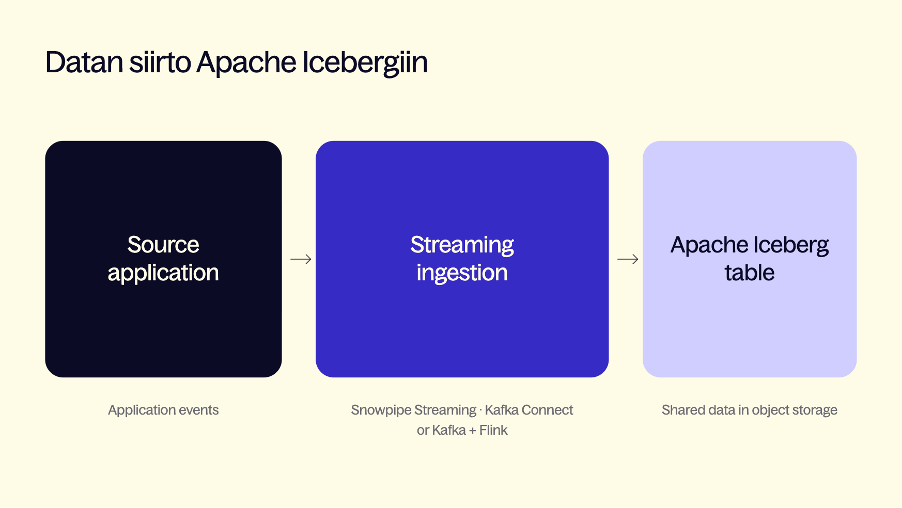 Data siirtyy Iceberg-tauluihin, joissa se on yhdenmukaista, skaalattavaa ja käytettävissä.
Yksi tapa on kirjoittaa data suoraan Iceberg-tauluun Snowpipe Streaming -tekniikalla Snowflaken hallinnoiman Iceberg-katalogin kautta. Sovellus lähettää tietueet tai tapahtumat ingestion-rajapinnan kautta, ja Snowflake rakentaa näistä Parquet-tiedostot sekä Iceberg-metadatan. Tallennustila voi olla Snowflaken oma, mutta sitä voidaan käyttää myös yhdistettynä ulkoiseen objektitallennukseen pilvialustassa. Tässä ratkaisussa Snowflake toimii lähinnä hallinnoidun ingestion- ja katalogikerroksen tarjoajana, ei niinkään perinteisenä ETL- tai warehouse-työkaluna.
Snowflake-ingestion-dokumentaatio.
Kafka tarjoaa toisen reitin. Kafka Connectin Apache Iceberg -sink connectorilla voi kirjoittaa tapahtumat jonosta Iceberg-tauluun. Kafka puskuroi streamin; connector kirjoittaa taulun tiedostot ja tekee commitit konfiguroidun katalogin kautta.
Apache Iceberg Kafka Connect -dokumentaatio.
Jos data tarvitsee ennen tallennusta enemmän käsittelyä, voidaan Flink laittaa Kafkan ja Icebergin väliin. Flink-jobi voi validoida ja suodattaa tapahtumia, laskea uusia kenttiä, rikastaa tietueita tai aggregoida niitä aikaikkunoihin ennen kuin tulos kirjoitetaan Iceberg-tauluun. Yksinkertaiset tietuetason muutokset voidaan hoitaa Kafka Connectin transformaatioilla, mutta Flink tulee käyttöön silloin, kun logiikka vaatii tilaa, liitoksia tai tapahtuma-aikaan perustuvaa käsittelyä.
Apache Iceberg Flink -kirjoitukset.
Käytä Kafka Connectia suoraviivaiseen ingestioniin, ja lisää Flink, kun prosessointivaatimus sen edellyttää.
Mistä säästöt syntyvät
Vähemmän kopioita ja vähemmän ylläpitoa
Oletetaan, että Trino, Databricks tai Snowflake voi lukea samaa Iceberg-taulua suoraan ilman erillistä ETL-importtia. Tällöin warehousen ei tarvitse tehdä omaa, erillistä tapahtumakopiota lähdeaineistosta.
Se poistaa kuitenkin paljon muuta kuin vain tallennustilaa. Samalla vähenevät ajastetut ETL-ajot, siirtoliikenne ja niihin käytetty aika.
Tämä on usein käytännössä suurin ja konkreettisin säästö. Se ei vaadi suurta arkkitehtuurimuutosta — riittää, että yksi ETL-työ ja yksi kopio poistetaan.
Vähemmän uudelleenprosessointia
Erillinen kustannus piilee monissa järkevissä ETL-töissä: lookback-ikkunoissa.
Tunneittain ajettava työ saattaa lukea uudelleen useiden päivien tapahtumia myöhästyneiden saapumisten vuoksi. Suuri osa näistä tietueista on jo käsitelty, joten työ toistaa vanhaa laskentaa. Myöhästynyt saapuminen voi vaatia yhden asiakkaan tuntikohtaisen laskennan uudelleenlaskennan. On tärkeää pohtia, voimmeko luotettavasti tunnistaa kyseisen tunnin ennen kuin päätämme uudelleenrakentaa jokaisen asiakkaan viimeiset kolme päivää. Meille tulee myös tämän myötä vähemmän uudelleenskannattavia tiedostoja.
Vähemmän skannattavia tiedostoja
Icebergin partitioinformaatio ja saraketilastot auttavat yhteensopivia moottoreita karsimaan epäolennaiset tiedostot kyselysuunnittelun aikana. Kysely yhden päivän tapahtumista voi välttää koko historian lukemisen, kun layout ja predikaatit sen sallivat.
Apache Iceberg -suodatus ja suorituskyky.
Open lakehouse voi tuoda jopa 90 % säästön käyttökuluihin
Tutkimusten ja käytännön esimerkkivertailujen perusteella open data lake, joka perustuu Apache Icebergiin ja Trinoon, voi olla jopa noin 90 % halvempi käyttää kuin tavanomainen warehouse-ratkaisu. Vertailuissa on tarkasteltu erityisesti tilanteita, joissa samaa suurta data-aineistoa luetaan ja skannataan toistuvasti. Kustannuksia ei siis ole arvioitu vain yksittäisen kyselyn perusteella, vaan sen mukaan, mitä tapahtuu silloin, kun dataa käytetään yhä uudelleen.
Tulokset viittaavat siihen, että ero syntyy ennen kaikkea erilaisesta kustannusmallista. Open lakehouse -ratkaisussa kulut muodostuvat pääosin objektitallennuksesta ja hallittavasta laskentakerroksesta. Tavanomaisessa warehouse-ratkaisussa kustannukset taas kasvavat herkemmin warehouse-ajasta, krediittikulutuksesta ja jatkuvasta aktiivisesta käytöstä. Esimerkkivertailuissa open lakehouse -ratkaisun kuukausikustannus oli noin 290 dollaria, kun vastaavassa warehouse-ratkaisussa käyttö oli noin 3 200 dollaria.
Toisessa vertailussa S3 + Iceberg + Trino -arkkitehtuurin kokonaiskustannus oli noin 2 230 dollaria kuukaudessa, kun tavanomaisessa warehouse-ratkaisussa kustannus nousi noin 23 440 dollariin. Näissä tapauksissa säästö oli parhaimmillaan noin 90 prosenttia.
Tämä ei tietenkään tarkoita, että open data lake olisi aina halvin vaihtoehto kaikissa tilanteissa. Tulokset kuitenkin osoittavat, että erityisesti toistuvissa skannaus- ja iterointikuormissa sen kustannusmalli voi olla selvästi kevyempi kuin perinteisessä warehouse-ratkaisussa.
Finsight Technologies — Open Lakehouse Market Data Platform ja D23 — Amazon S3 + Iceberg + Trino: cost-effective lakehouse.
Entä voidaanko Icebergin ja Trinon avulla rakentaa data lake -arkkitehtuuria?
Vastaus on kyllä, Icebergin ja Trinon avulla voidaan rakentaa toimiva data lake -arkkitehtuuri. Iceberg tarjoaa vakaan, avoimen tauluformaatin, Trino toimii SQL-kyselymoottorina, dbt hoitaa transformaatioita ja Airflow tai muu scheduler vastaa ajastuksista. Tämä on käytännössä moderni lakehouse-malli, joka voi toimia myös ilman kaupallista warehouse-ratkaisua. BI-työkalut, kuten Power BI ja Tableau, voivat lukea tätä dataa Trinon kautta, jolloin koko järjestelmä pysyy kevyenä, avoimena ja helposti skaalattavana.
Data lake -arkkitehtuuri
Seuraava arkkitehtuuri havainnollistaa, miten SQL-analytiikka ja graafianalytiikka toimivat samassa Apache Iceberg -datassa lakehouse-ympäristössä.
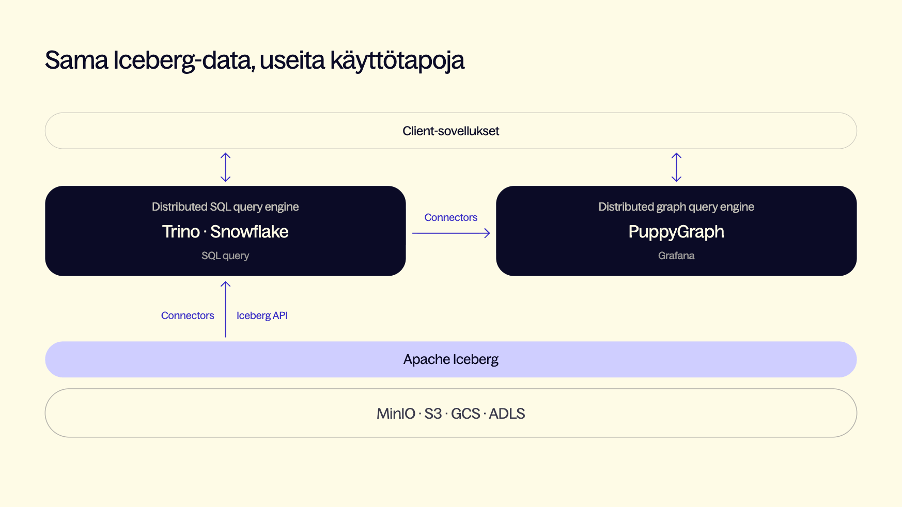 SQL- ja graafianalytiikka Apache Icebergillä Trinoa, Snowflakea ja PuppyGraphia hyödyntäen.
Samanlainen rakenne voidaan myös rakentaa esimerkiksi Docker-konteissa, mikä tarkoittaa, että sama malli sopii hyvin myös on-prem-ratkaisuksi. Tällöin data voi säilyä omassa object storage -ympäristössä, kun taas Trino, dbt ja scheduler toimivat palveluna paikallisesti tai yrityksen omassa infrastruktuurissa. Tämä tekee lakehouse-arkkitehtuurista käytännöllisen vaihtoehdon sekä pilviympäristöihin että yritysten omiin ympäristöihin.
Iceberg-tauluja voidaan lukea sekä Trinolla että esimerkiksi PuppyGraphilla ilman erillistä kopiointia toiseen graafitietokantaan. Tämä havainnollistaa, miten yksi data lakehouse voi palvella sekä aggregoivaa BI-analytiikkaa että käyttäjien SQL-kyselyitä. Starburst + PuppyGraph — SQL and Graph Analytics on Apache Iceberg.
Esimerkkejä Icebergin käytöstä
Shopify: yhteinen tauluformaatti eri työkaluille
Shopifyn tiimit käyttivät useita tauluformaatteja, mikä teki uusien työkalujen käyttöönottamisen hankalammaksi ja vaati adaptereita olemassa olevien datasettien käyttämiseen. Yritys otti Icebergin käyttöön yhteiseksi formaatiksi ja käytti Trinoa migraation aikana. Opetus on suoraviivainen: tauluformaatin jakaminen voi vähentää integraatiotyötä, jota tarvitaan olemassa olevan datan saamiseksi toiselle kuluttajalle. Shopify — Iceberg ja Trino -migraatio.
Ancestry: jaettu datasetti eri tiimeille
Ancestryllä tiimit käyttivät Hints-datasettiä palvelukutsujen, Kafka-tilausten ja warehouse-kyselyjen kautta. Nämä erilliset polut aiheuttivat datan duplikaatiota ja tarpeetonta järjestelmäkuormaa. Tiimi otti käyttöön keskitetyn Iceberg-datajärven analyyttisten työmäärien tukemiseksi yhteisestä datasetistä. Ancestry — 100 miljardin rivin Iceberg-taulun optimointi.
Netflix: merkityksellisten muutosten käsittely
Netflix rakensi inkrementaalisen prosessointijärjestelmän Maestron ja Icebergin avulla seuraamaan muutoksia ja kaventamaan dataa, jonka downstream-työt käyvät läpi. Säästö tulee Icebergin ympärille rakennetusta prosessointisuunnittelusta — pelkkä tauluformaatin vaihtaminen ei tuota sitä. Netflix — Inkrementaalinen prosessointi Maestron ja Icebergin avulla.
Miten teidän yrityksessänne dataputket on rakennettu? Perustuuko arkkitehtuuri vielä perinteisiin ETL-putkiin, vai oletteko jo siirtyneet avoimien tauluformaattien suuntaan?
Lähteet ja lisälukemista
- Apache Iceberg — Johdanto — Tauluformaatin perusteet, snapshotit, skeeman evoluutio ja tiedostojen karsinta.
- Snowflake — Streaming Iceberg-tauluihin — Hallittu ingestion, katalogivaatimukset ja tallennusvaihtoehdot.
- Apache Iceberg — Kafka Connect — Kafka-tapahtumien kirjoittaminen Iceberg-sink-connectorilla.
- Apache Iceberg — Flink-kirjoitukset — Stream-prosessoinnin tulosten kirjoittaminen Iceberg-tauluihin.
- Apache Iceberg — Spark Structured Streaming — Streaming-lukemat ja -kirjoitukset, tarkistuspisteet ja operationaaliset näkökohdat.
- Finsight Technologies — Open Lakehouse Market Data Platform — S3 + Parquet + Iceberg + Trino -arkkitehtuurin kustannusvertailu.
- D23 — Amazon S3 + Iceberg + Trino: cost-effective lakehouse — Amazon S3 + Iceberg + Trino -ratkaisun kustannusten vertailu.
- Shopify — Iceberg ja Trino -migraatio.
- Ancestry — 100 miljardin rivin Iceberg-taulun optimointi.
- Netflix — Inkrementaalinen prosessointi Maestron ja Icebergin avulla.
- Apache Iceberg — Ylläpito.
- Starburst + PuppyGraph — SQL and Graph Analytics on Apache Iceberg — Sama Iceberg-taulu toimii sekä SQL-kyselyiden että graafianalytiikan lähteenä ilman erillistä kopiointia.
Haluatko jutella aiheesta lisää?
Ota yhteyttä, jos haluat vaihtaa ajatuksia aiheesta asiantuntijamme kanssa.